Marktforschung in Claude: Personas zeigen vor dem Launch, welche Fassung trägt.
Bisher entscheidet die Freigaberunde. Jede Persona ist aus öffentlichen Kundenstimmen recherchiert, mit Zitat und Quelle. Ihr braucht keinen Traffic, der Live-Test kommt danach.
 Head of Marketing, SaaSEinkäuferin
 WiedereinsteigerinPrivatkundin
99takes · test_page· 12 Personas, 48 Urteile„…exactly what I can defend to the attorney and finance.“  Inhaber, WerbeagenturEinkäufer
 Performance ManagerEinkäufer
 Handwerker in RenteWähler
Ein Satz in Claude genügt. Zum Beispiel:
- Seite testen
„Teste meine Startseite gegen meine Zielgruppe und schreib eine bessere Fassung.“
Zurück kommt die neue Fassung zum Freigeben, dann das Urteil.
Kostenlos ausprobieren → - Headlines vergleichen
„Welche dieser zwei Headlines holt mehr Klicks bei meinen Kunden?“
Zurück kommt, welche vorn liegt, und je Persona der Einwand, an dem die andere hängenbleibt.
Kostenlos ausprobieren → - Wettbewerb prüfen
„Welche Aussagen auf meiner Seite machen meine Wettbewerber genauso?“
Zurück kommt je Kernaussage: besetzt, umstritten oder frei, mit wörtlichem Zitat und Quelle.
Kostenlos ausprobieren →
Freigegeben wird, wer am lautesten widerspricht. Dann geht es live, und ihr wartet Wochen auf Daten.
Die dritte Korrekturschleife kennt ihr. Getestet wurde trotzdem nichts.
 KI generiert
99takes · test_page· 12 Personas, 48 Urteile- 01
Ihr habt zu wenig Traffic für einen A/B-Test?
Dann prüft ihr vorher, nicht live. Eine kleine Seite kommt nie zum signifikanten Ergebnis. Das Urteil braucht ihr vor dem ersten Klick.
- 02
Wer vorn liegt, testet vor dem Launch.
Wer die Botschaft zuerst testet, geht mit der besseren Fassung an den Start. Wer nach Geschmack freigibt, zahlt mit Budget und Wochen.
- 03
So fühlt es sich an, wenn es klappt.
Ihr wisst vor dem Launch, welche Fassung trägt. Und ihr wisst, warum: wo die Personas hängenbleiben, verwirrt sind oder abspringen.
Warum nicht einfach Claude fragen?
Die Jury von 99takes läuft selbst auf Claude. Der Unterschied liegt darin, wen das Modell spielt.
Fragt ihr selbst, rät das Modell, wer bei euch kauft.
Zwei Prompts liefern oft zwei gegensätzliche Urteile.
Die Personas kommen aus Wettbewerbertexten und öffentlichen Kundenstimmen, jede mit Zitat und Quelle.
✓10 bis 14 Personas lesen denselben Text, jede auch unter den Jobs der anderen.
Ihr seht, wo es wiederholt hakt.
Nicht ausgedacht, nachgelesen.
Jede Persona ist aus öffentlichen Kundenstimmen recherchiert, mit Zitat und Quelle. Diese stammt aus der Zielgruppe, mit der wir diese Seite geprüft haben.
Kunden geben meine Entwürfe in ChatGPT und kommen mit dessen Feedback zurück.
Forenbeitrag, sinngemäßÄndere ich eine Stelle, ändert sich alles andere mit, auch was mir gefiel.
Forenbeitrag, sinngemäß KI generiert Freelance-TexterinSimulierte Persona · 2 Quellen
„Zitat und Quelle“ gleich oben gibt mir etwas, das ich meinem Kunden zeigen könnte, statt nur ein weiteres KI-Urteil.Was sie bremst
Meine Kunden kommen schon mit ChatGPT-Feedback. Ich fürchte, auch dieses Ergebnis wirkt auf sie wie eine weitere KI-Meinung.
Simulierte Persona, Sätze im Wortlaut. Run vom 12.10.2026: der Hero dieser Seite gegen die Fassung davor.
So sieht ein Ergebnis aus: Tappla.
Tappla ist unser eigenes SaaS für TV-Apps, verkauft in den USA. Wir haben den Hero von tappla.com aus dem Juli 2026 gegen eine neue Fassung antreten lassen, mit 12 Personas aus der Zielgruppe.
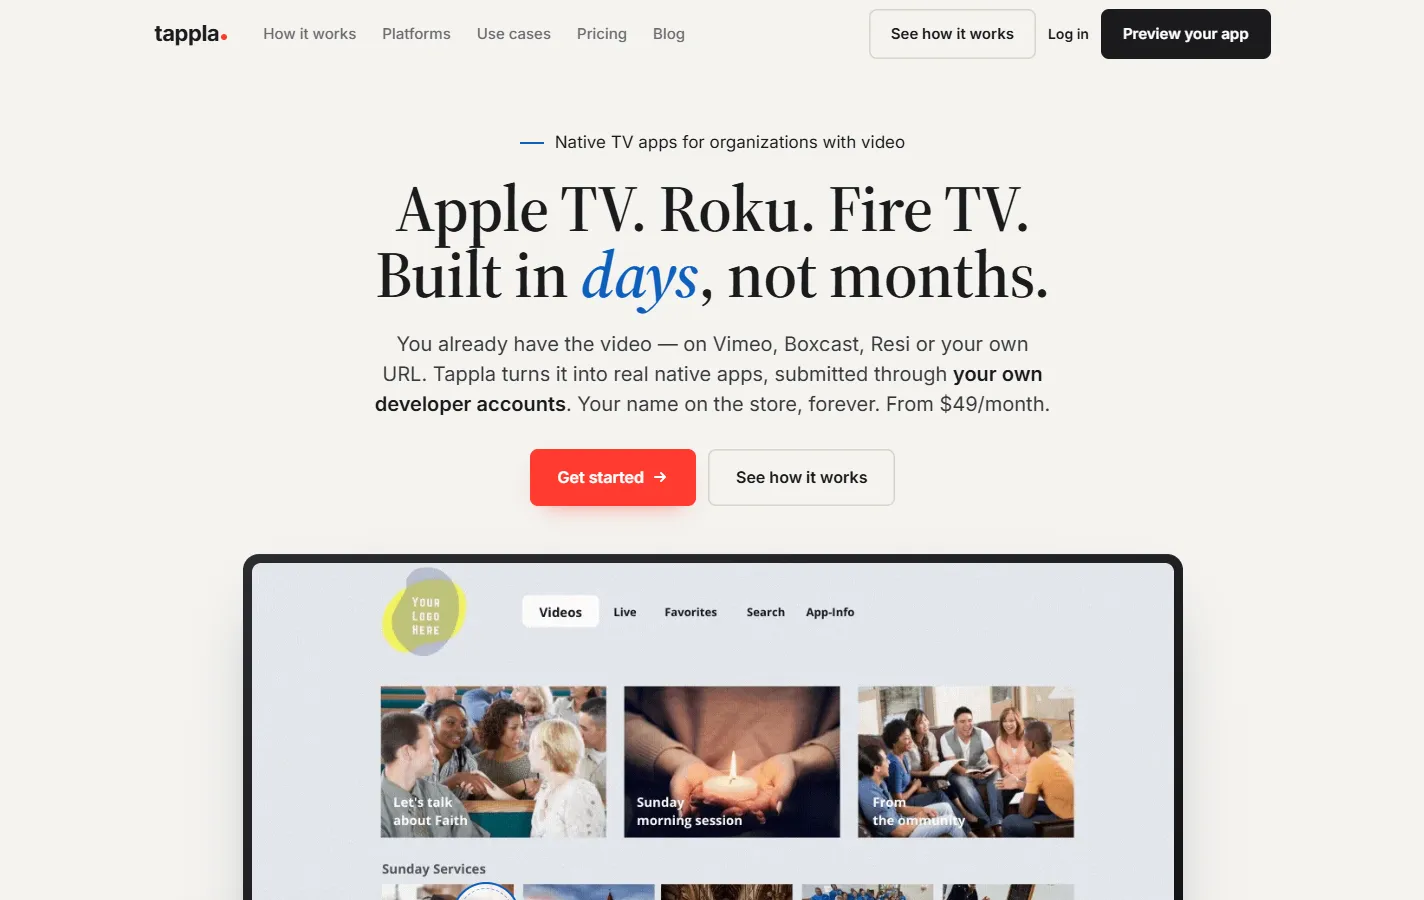
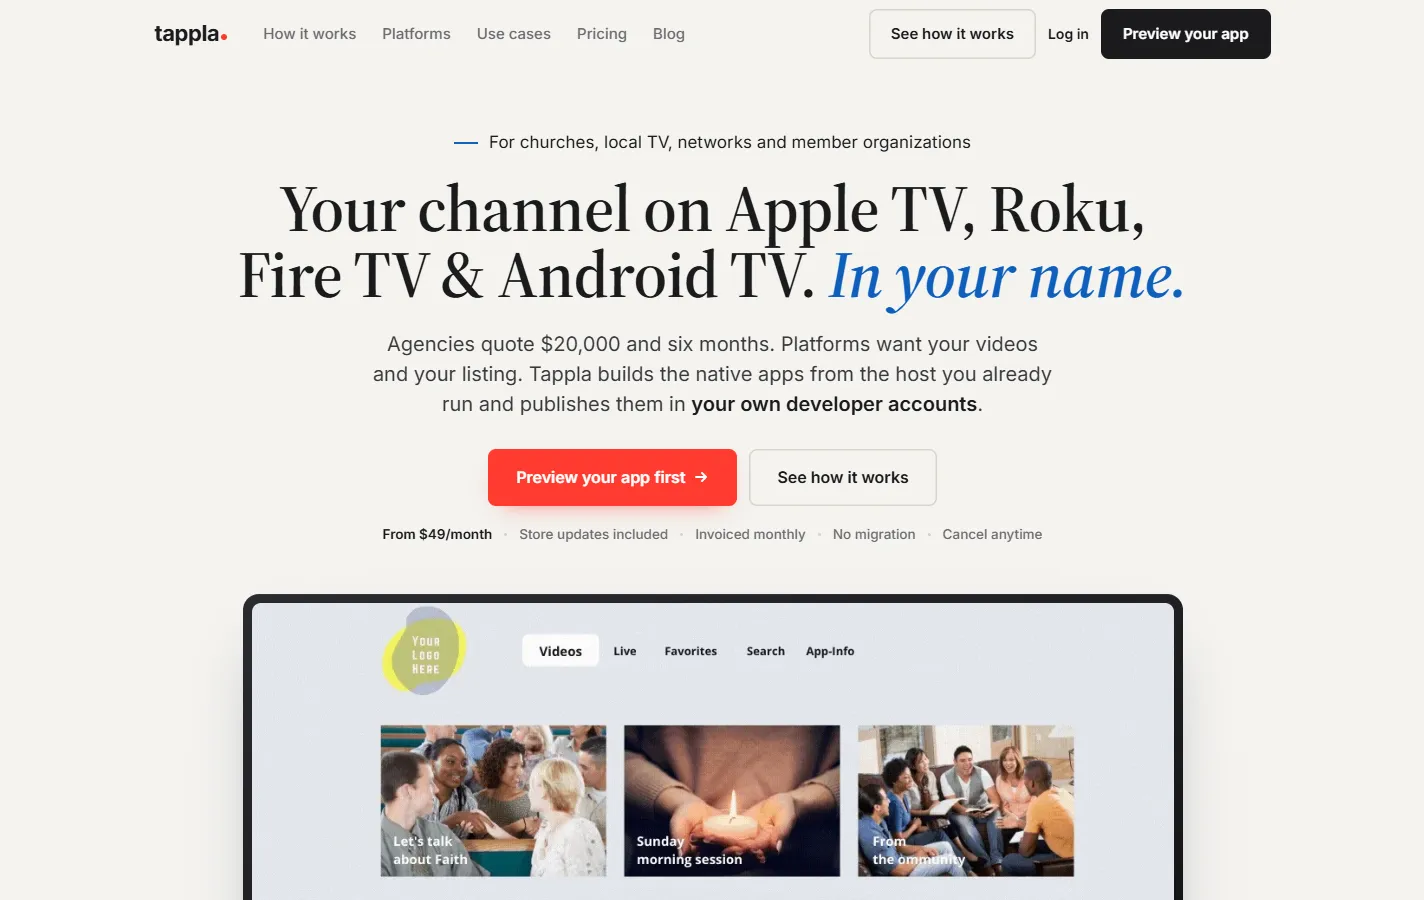
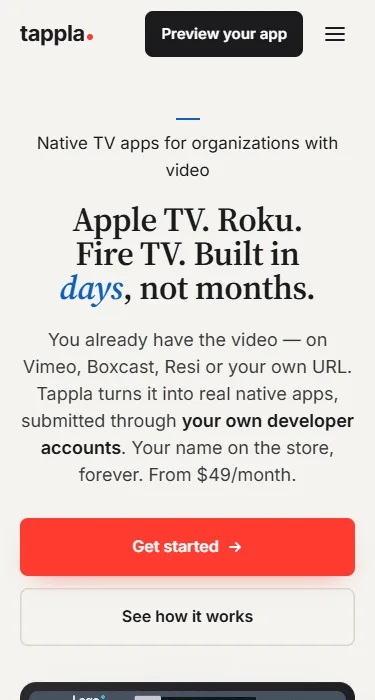
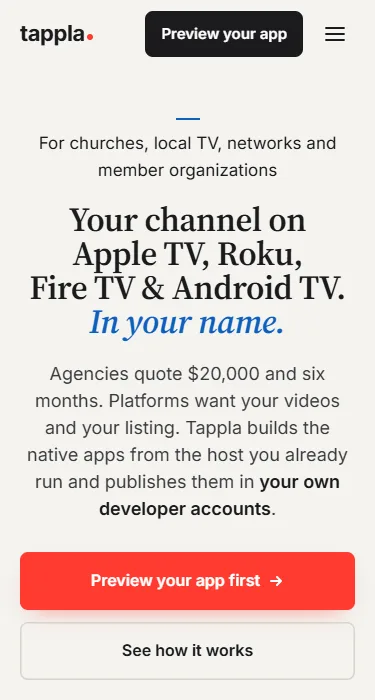
Bildschirmfotos von tappla.com. Dieselbe Seite, nur der Text des Heros getauscht: so wurde getestet. 12 Personas, 48 Urteile, 12.10.2026.
Ob eure Leser Einkäufer, Privatkunden oder Wähler sind.
Agenturen und Texter Prüft eure Anzeigen und Landingpages, bevor sie zum Kunden gehen. Challenger schreiben → Marketing-Teams mit Freigaberunde Geht mit einem Urteil in die Abstimmung statt mit Geschmack. Texte prüfen → Konsumgüter und Politik Für Leser, die nicht im Einkauf sitzen: Privatkunden und Wähler als eigene Zielgruppe. Zielgruppe recherchieren → Bilder KI generiert, Personen fiktiv.
Vier Aufgaben, ein Gespräch in Claude.
Wie oft lag die Jury richtig?
Der Live-Test kommt danach. Ihr meldet, welche Fassung am Markt gewonnen hat, und 99takes rechnet daraus die Trefferquote je Jury.
Eine Simulation ist keine Marktmessung. Sie kommt vor dem A/B-Test mit echtem Traffic und ersetzt ihn nicht.
So entsteht die Trefferquote →Einmal verbinden, dann fragen.
99takes läuft direkt in Claude, dort wo eure Texte ohnehin entstehen. 350 Credits für 30 Tage, ohne Zahlungsdaten.
- 1Konto anlegenAuf run.99takes.com, mit 350 Credits für 30 Tage.
- 2Claude verbindenIn claude.ai als Connector eintragen oder in Claude Code einen Befehl ausführen.
- 3FragenLandingpage nennen oder zwei Fassungen einfügen. Den Rest fragt 99takes nach.
Selbst prüfen oder prüfen lassen.
Selbst nutzen
Vor jedem Run seht ihr den Preis in Credits. Ein Vergleich zweier Fassungen mit 12 Personas kostet etwa 73 Credits, im Starter-Plan knapp 11 €, 1:1 mit nur dem eigenen Job etwa 19 Credits.
Wir machen es für euch
Buyer Research, eure Zielgruppe als Personas und ein Bericht mit Empfehlungen, gemacht von 99takes. Als Studie zum Festpreis von 990 € oder als Retainer ab 1.500 € im Monat, jeweils netto.
Gespräch anfragen